Как на самом деле работают нейросети: пошаговый разбор на пальцах
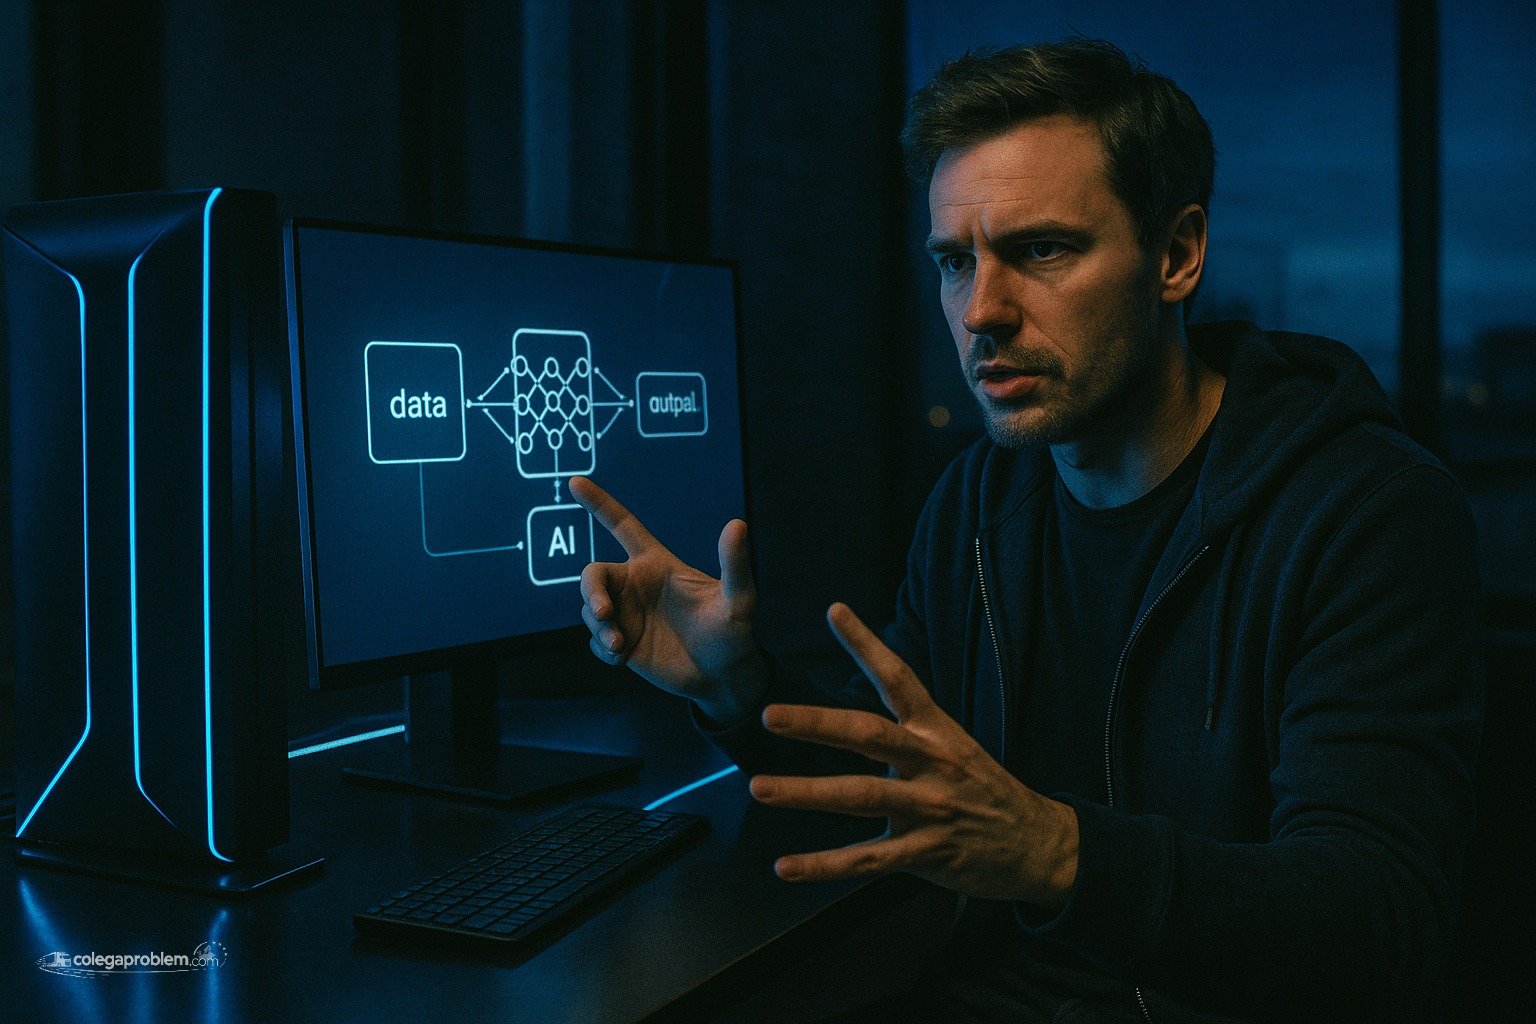
Разбор архитектуры искусственного интеллекта от одного нейрона и весов до скрытых слоев и обратного распространения ошибки.
Искусственный интеллект окружает нас повсюду, однако для большинства пользователей внутреннее устройство алгоритмов остается загадкой. Вопреки распространенному заблуждению, внутри вычислительных систем нет органических клеток, биологических импульсов или зачатков человеческого сознания. Инженер Pasquale Pillitteri отмечает: любая искусственная нейросеть представляет собой программную математическую конструкцию, которая учится распознавать закономерности в массивах данных с помощью непрерывной цепочки умножений и сложений. Чтобы понять принцип работы этих систем без сложной теории, достаточно разобрать их архитектуру по шагам — от простейшей вычислительной ячейки до многослойных комплексов.
Анатомия отдельного нейрона и математика передачи сигнала
Фундаментальным строительным блоком любой нейросети служит искусственный нейрон, который существенно проще своего биологического прототипа. Биологическая клетка управляется сложнейшими электрохимическими процессами с тысячами синапсов, тогда как ее виртуальный аналог описывается лаконичной математической формулой. Вычислительная работа одного нейрона состоит из четырех последовательных операций, которые можно проиллюстрировать примером взвешивания аргументов перед принятием решения.
1. Прием входных параметров. Нейрон получает на вход набор числовых значений. Если речь идет о распознавании графики, в ячейку поступают показатели яркости отдельных пикселей, а если анализируются тексты — векторные индексы слов.
2. Умножение на весовые коэффициенты. Каждому входящему сигналу присваивается собственный вес. Вес отражает степень важности конкретного параметра: чем он выше, тем сильнее входящее число влияет на итоговый результат, а отрицательный вес, напротив, подавляет влияние признака.
3. Сложение взвешенных сигналов и добавление смещения. Система вычисляет сумму всех произведений и прибавляет к ней фиксированное число — смещение (bias). Смещение играет роль порога чувствительности: оно сдвигает итоговую прямую, позволяя нейрону гибко реагировать даже в тех случаях, когда все входные переменные равны нулю.
4. Пропуск через функцию активации. Полученная сумма передается в специальную функцию, определяющую силу сигнала на выходе. Исследователи использовали сигмоиду, сжимающую результат в диапазон от нуля до единицы. В современных архитектурах чаще применяется функция ReLU (Rectified Linear Unit). Принцип ее работы простой: любые отрицательные значения обнуляются, а положительные беспрепятственно передаются дальше.
Рассмотрим конкретный расчет: пусть на входы нейрона подаются сигналы 0.5 и 0.8, веса связей равны 0.4 и -0.2 соответственно, а постоянное смещение составляет 0.1. Первое умножение дает 0.20, второе формирует отрицательную величину -0.16. При суммировании получается 0.04, а добавление смещения дает 0.14. Функция ReLU оставляет положительное число без изменений, отправляя 0.14 на следующий уровень обработки. Искусственный нейрон выполняет взвешенное суммирование входных сигналов и выдает конечное число, на основе которого формируется поведение всей последующей цепочки.
Архитектура скрытых слоев и путь данных к результату
Единичная ячейка может решать только линейные задачи. Объединение нейронов в слои позволяет реализовать глубокое обучение (Deep Learning). Архитектура нейросети делится на три функциональные зоны: входной уровень, скрытые промежуточные слои и выходной слой. Входной слой не выполняет вычислений — он преобразует входные данные (звуковые колебания, текст или изображения) в числовые матрицы.
1. Преобразование входного потока. Матрица сырых данных разделяется на элементарные компоненты. Например, фотография размером 28 на 28 точек разбивается на 784 независимых числа, каждое из которых попадает в соответствующий сенсор входного ряда.
2. Извлечение первичных признаков на ранних слоях. В первом скрытом слое каждый узел связан с входными данными. На этом этапе нейроны реагируют на простейшие контрасты: резкие границы, линии, световые переходы и базовые геометрические штрихи.
3. Формирование сложных паттернов в глубине сети. Следующие скрытые слои комбинируют информацию от предыдущих ячеек. Из простых отрезков собираются контуры геометрических фигур, а на еще более глубоких уровнях алгоритм синтезирует комплексные текстуры и узнаваемые фрагменты объектов — например, форму глаза или очертание автомобильного колеса.
4. Расчет вероятностей на выходном слое. Финальный уровень сети берет высокоуровневые признаки и выдает окончательный ответ задачи. В системах классификации выходной слой обычно использует функцию Softmax, которая переводит финальные суммы в распределение вероятностей между заданными классами. Если на изображении запечатлен домашний питомец, система выдает оценку вроде 0.92 для класса «кот» и 0.08 для класса «собака».
Скрытые слои позволяют сети распознавать сложные закономерности в данных. В то время как классическое программное обеспечение требует жестко прописанных инструкций для каждой ситуации, нейросеть самостоятельно находит в данных скрытые правила. Скрытые слои формируют иерархию признаков, двигаясь от распознавания примитивных контуров к осмыслению целостных визуальных и семантических образов без прямого вмешательства разработчика.
Цикл обучения и алгоритм обратного распространения ошибки
Архитектура из миллионов нейронов работает корректно только после настройки коэффициентов. При создании модели все веса инициализируют случайными числами, поэтому первые ответы системы случайны и неправильны. Обучение алгоритма представляет собой циклический процесс из четырех повторяющихся шагов, направленных на планомерное сокращение расхождений между гипотезами сети и реальностью.
1. Прямой проход (Forward Propagation). Данные из обучающей выборки подаются на входной слой и проходят через всю цепь перемножений и активаций до выходного слоя, формируя текущее предсказание модели.
2. Оценка величины промаха через функцию потерь. Полученный ответ сопоставляется с эталонной меткой. Специальное уравнение, называемое функцией потерь (Loss Function), количественно измеряет масштаб ошибки. Например, метод среднеквадратичной ошибки определяет квадрат разницы между прогнозом и правильным числом, превращая неточность в измеримый штрафной балл.
3. Обратное распространение ошибки (Backpropagation). Это ключевой математический шаг тренировки. Вычисленная величина промаха направляется в обратную сторону — от выхода ко входу. Опираясь на математический аппарат частных производных и цепное правило математического анализа, алгоритм определяет степень вины каждого конкретного веса в итоговой ошибке всей цепочки.
4. Корректировка параметров с помощью градиентного спуска. Когда мера влияния каждого веса найдена, система делает небольшой корректирующий шаг. Веса сдвигаются в сторону, противоположную направлению ошибки. Размер этого сдвига регулируется коэффициентом скорости обучения (Learning Rate): слишком большой шаг приведет к расшатыванию системы, а чрезмерно маленький сделает обучение бесконечно долгим.
Повторяя этот четырехтактный цикл на миллионах примеров, сеть постепенно шлифует свои коэффициенты. В 2024 году Шведская королевская академия наук подчеркнула значимость этих базовых механизмов, присудив Нобелевскую премию по физике Джону Хопфилду и Джеффри Хинтону за фундаментальные открытия, сделавшие возможным современное машинное обучение. Обратное распространение ошибки минимизирует расхождения, шаг за шагом направляя миллионы числовых параметров к значениям, гарантирующим точный результат.
Источники
- Pasquale Pillitteri — руководство по принципам работы искусственных нейросетей с пошаговыми вычислениями и инфографикой.
- Nobel Prize Outreach — официальный пресс-релиз Нобелевского комитета о вручении премии за развитие искусственных нейросетей.
- MIT Technology Review — технический разбор архитектуры глубоких нейронных сетей и алгоритмов машинного обучения.
Читайте также
Ещё несколько материалов, которые могут вас заинтересовать.
AgentWP final guest comment acceptance test — 2026-10-04